协创数据智慧工厂建设项目中的数据处理与存储支持服务
一、项目背景
协创数据技术股份有限公司(以下简称“协创数据”)是国内领先的智能硬件与数据服务提供商,主营业务涵盖智能摄像机、智能穿戴、智能家居等物联网终端设备的研发、生产与销售。随着业务规模持续扩大和客户对产品品质、交付效率要求的不断提升,协创数据启动了智慧工厂建设项目,旨在通过数字化、网络化、智能化手段,实现生产过程的全面感知、实时分析与精准控制。在该项目中,数据处理和存储支持服务作为核心基础支撑,直接决定了智慧工厂各应用系统能否高效、稳定、安全地运行。
二、建设目标
协创数据智慧工厂建设项目的总体目标是打造一个集自动化生产、数字化管理、智能化决策于一体的现代化工厂。其中,数据处理和存储支持服务需要实现以下具体目标:
- 海量数据汇聚:支持生产线设备、传感器、扫码终端、视频监控等多源异构数据的统一采集与汇聚,日均处理数据量达到TB级。
- 实时数据处理:对生产节拍、设备状态、质量检测等关键数据实现毫秒级至秒级的实时处理与反馈。
- 可靠数据存储:构建分级存储体系,满足结构化数据、非结构化数据(如图像、视频)的长期、安全、可扩展存储需求。
- 数据服务能力:向上层MES、WMS、ERP、BI等系统提供标准化的数据接口与服务,支撑生产调度、质量追溯、能耗分析等业务场景。
- 安全与合规:确保数据在采集、传输、存储、使用全生命周期中的安全性,符合国家数据安全法规及行业标准。
三、数据处理支持服务
3.1 数据采集与接入
智慧工厂内部署了数千台生产设备、检测仪器和传感器,数据来源包括PLC控制器、工业机器人、AOI光学检测设备、RFID读写器、门禁系统、环境监测传感器等。数据处理服务首先需要完成多协议适配,支持Modbus、OPC UA、MQTT、HTTP/RESTful、JDBC等主流工业协议和接口标准,将不同来源的数据统一接入数据平台。
3.2 数据清洗与预处理
原始数据中往往存在噪声、缺失值、重复记录和格式不一致等问题。数据处理服务内置规则引擎与流式计算框架,对采集到的数据进行实时清洗、去重、补全、格式转换和标准化处理。例如,对设备状态数据进行有效性校验,剔除异常波动;对质量检测图像进行尺寸归一化和去噪,提升后续AI分析的准确性。
3.3 实时流处理
针对生产线上对时延敏感的应用场景(如设备故障预警、质量在线检测、AGV调度等),数据处理服务采用分布式流处理架构(如Apache Kafka + Apache Flink),实现数据的实时消费、窗口计算、事件关联和规则触发。例如,当检测到某台注塑机的温度持续超过阈值时,系统在200毫秒内生成告警并推送至MES系统,触发停机或调参操作。
3.4 批量数据处理
对于非实时性要求的业务,如生产报表统计、历史数据分析、模型训练等,数据处理服务提供批量计算能力。通过任务调度引擎(如Apache Airflow)定期从存储层抽取数据,执行ETL作业和 MapReduce/Spark 计算任务,生成各类汇总指标和分析结果,供管理层决策使用。
3.5 数据质量管理
数据处理服务包含完整的数据质量管理模块,定义数据的完整性、准确性、一致性、及时性等质量维度,通过自动化监控和告警机制,及时发现并修复数据质量问题。建立数据血缘关系,追踪数据从产生到消费的全链路,便于问题定位和影响分析。
四、存储支持服务
4.1 存储架构设计
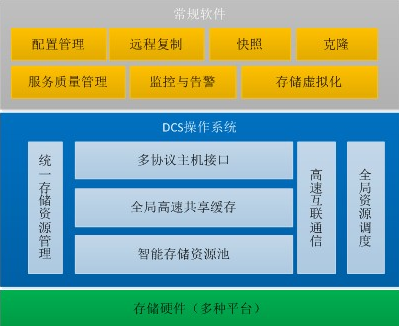
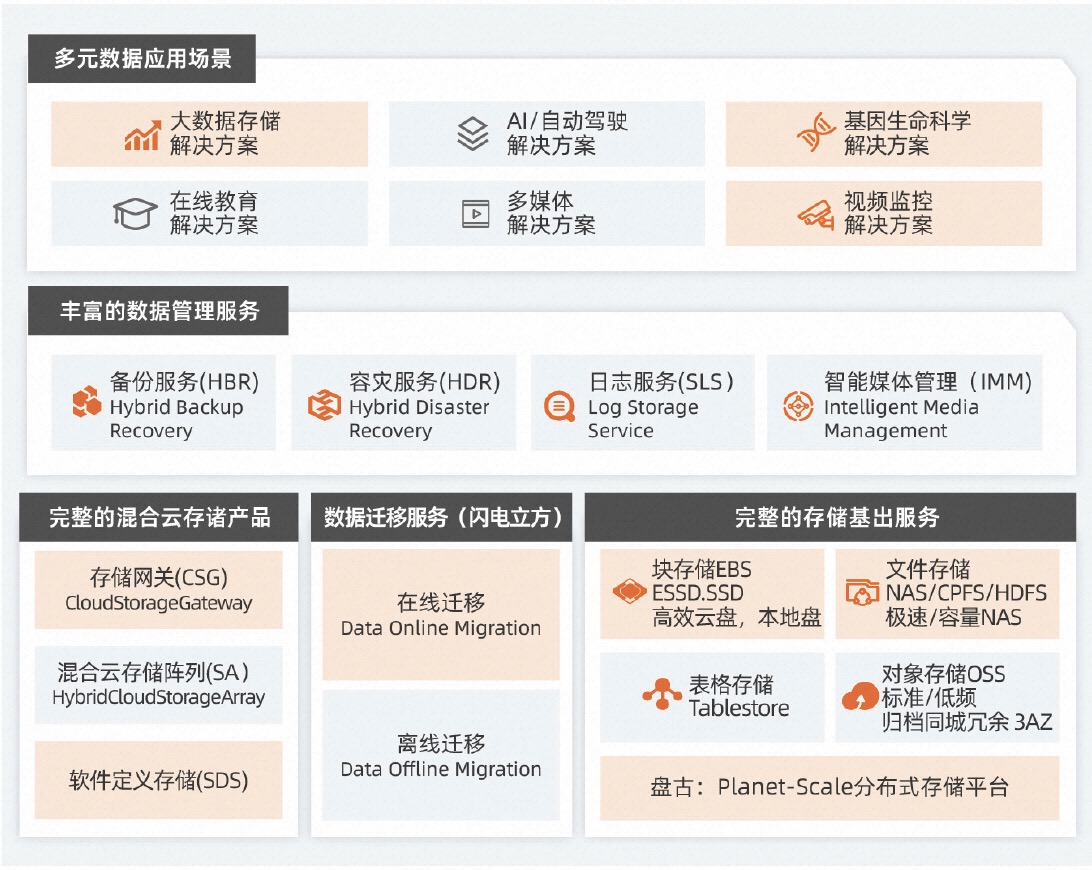
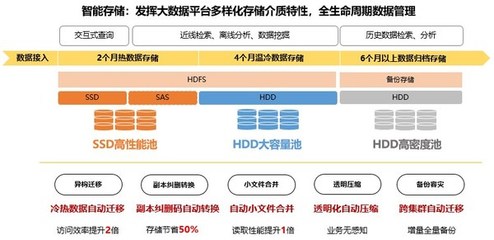
协创数据智慧工厂的存储支持服务采用分级、分布式、高可用的架构设计。整体分为在线存储、近线存储和离线存储三个层次:
- 在线存储:采用高性能全闪存阵列和分布式数据库(如TiDB、ClickHouse),支撑实时数据处理和热点数据的高并发访问。
- 近线存储:采用大容量SAS/NL-SAS磁盘阵列和对象存储(如MinIO、Ceph),用于存储近期的历史数据、日志文件和备份数据。
- 离线存储:采用磁带库或低成本云存储,用于长期归档和法规遵从要求的数据留存。
4.2 结构化数据存储
生产工单、物料信息、质量记录、设备台账等结构化数据,采用关系型数据库(如MySQL、PostgreSQL)和分布式SQL数据库进行存储。通过分库分表、读写分离和索引优化,支撑高并发的事务处理和分析查询。
4.3 非结构化数据存储
智慧工厂产生大量非结构化数据,包括AOI检测图像、监控视频、语音日志、PDF报表等。这些数据通过对象存储服务进行统一管理,支持S3/Swift标准接口,具备高扩展性、高持久性和低成本优势。结合元数据管理,实现非结构化数据的快速检索和生命周期管理。
4.4 时序数据存储
设备传感器、能耗监测等场景产生高频时序数据。存储支持服务采用专用时序数据库(如InfluxDB、TimescaleDB)进行存储,支持高写入吞吐、时间窗口聚合和降采样查询,满足设备状态监控和能耗分析的需求。
4.5 数据备份与容灾
为确保数据安全,存储支持服务建立了完善的备份与容灾机制。核心数据每日全量备份、每小时增量备份,备份数据异地存放。关键业务系统采用双活或主备架构,RPO≤15分钟,RTO≤30分钟,确保在灾难发生时快速恢复业务。
五、关键技术选型
| 层次 | 技术组件 | 用途 |
|------|----------|------|
| 数据采集 | Telegraf、Filebeat、Flume | 多源数据采集与转发 |
| 消息队列 | Apache Kafka | 数据缓冲与解耦 |
| 流处理 | Apache Flink | 实时计算与事件处理 |
| 批处理 | Apache Spark | 离线分析与ETL |
| 数据存储 | TiDB、ClickHouse、InfluxDB、MinIO | 结构化/时序/非结构化存储 |
| 数据服务 | GraphQL、RESTful API | 统一数据服务接口 |
| 数据治理 | Apache Atlas | 元数据与数据血缘管理 |
| 任务调度 | Apache Airflow | 批处理作业调度 |
| 监控运维 | Prometheus + Grafana | 系统与数据质量监控 |
六、实施成效
协创数据智慧工厂建设项目的数据处理和存储支持服务上线后,取得了以下显著成效:
- 生产效率提升:设备数据实时采集与处理,使设备综合效率(OEE)提升12%,生产异常响应时间缩短70%。
- 质量水平提高:基于实时数据的质量在线检测与追溯,产品不良率降低35%,客诉率下降40%。
- 运营成本降低:通过能耗数据分析与优化,单位产品能耗下降8%;自动化数据采集替代人工录入,节省人力成本约20%。
- 数据驱动决策:构建统一数据视图,管理层可实时掌握生产、库存、质量、能耗等关键指标,决策周期从周级缩短至小时级。
- 安全合规保障:数据全生命周期安全管控,通过等保三级测评,满足客户及监管机构的数据安全要求。
七、与展望
数据处理和存储支持服务是协创数据智慧工厂建设项目的数字底座,决定了工厂智能化的深度与广度。通过构建高性能、高可靠、可扩展的数据处理与存储体系,协创数据实现了生产全流程的数据贯通与价值挖掘。随着5G、边缘计算、AI大模型等技术的进一步融合,协创数据将持续优化数据架构,探索数据要素市场化配置,打造更具竞争力的智能制造标杆工厂。
如若转载,请注明出处:http://www.fotph.com/product/36.html
更新时间:2026-10-30 01:18:15